实用 or 效率?说说AI 界的“崇洋媚外”论
这几天,OpenAI 的 devday 大会连发诸多新功能,横跨 GPT-6 Astra、ChatGPT、Codex、API、安全以及一批新的开发者构建工具;此前还有 A 社的 Claude Sonnet5.5等一众更新,让人目不暇接。
月亮是国外的圆?
讲真,我一直准备尝试 ChatGPT ,也想注册一个新 Claude 账号(之前被波及误封了)。这些最新的 AI 模型确实让人振奋。
但是,我边期待,边沉迷于更易得的工具怀抱之中,特别是九月发布的 DeepSeek Harness,还有九月开始付费的 K3.
有时候和朋友或客户聊天,我就说国外 AI 虽好,但总是嬉笑打趣的说 “花美元赚人民币”总不是很合算。
不可否认,AI 确实是美国遥遥领先,中国紧随其后但距离不小。我用过一段时间 Claude Fable 5、Opus模型,它们在长文本理解、生成图片方面确实令我惊艳。
也正是这样的经验,让我对今年整理完《大数据分析通识》有了信心。
只是,无形之中,我一直对高度依赖国外模型保持“距离感”,其中既有成本因素,也有商业交付考量,更有探索性的味道。
随着 DeepSeek Harness 的持续进步(虽然仅仅到0.1.0 版本),我对国产工具的信心确实在增强。
DeepSeek Harness 的体验对比
近期,我在开发一个基于 Tableau Server 的应用高度依赖于 Codebuddy+GLM 模型,也时常使用 ChatGPT 5.6做“探索性”工作。
莫名之中,我对ChatGPT 之类的工具有一种“瞻仰感”,所以常常会把最难的事情分给它做,然后用 GLM 做检查或实现。这就是一个技术上的“崇洋媚外”。
不过,我今天猛然觉得,DeepSeek Harness 的巨大进步,正在让我扭转这种想法。我用多个工具检查了一个应用的代码。
我给了 Codebuddy 国际版,它使用的国际模型 GPT。
ChatGPT 的回答:
本次更新整体质量较高,在模块化拆分、类型安全、测试基建、请求规范、后端服务设计等方面均符合 TypeScript/React/NestJS 现代开发的最佳实践。主要扣分点在于 Prisma 查询中的 as any 类型逃避、Controller 中的魔法数字,以及 commit 粒度过大。建议后续修复上述类型和常量问题,并继续补充测试覆盖。
但是,当我把同一个问题给 dsh, DeepSeek v4.1flash 给了令我生畏的检查结果:大量的风险点。
我起初还以为,会不会是 DeepSeek v4.1flash 的评估不够严谨?
但,当我发给 ChatGPT,它给出溢美之词并开始自我反思。
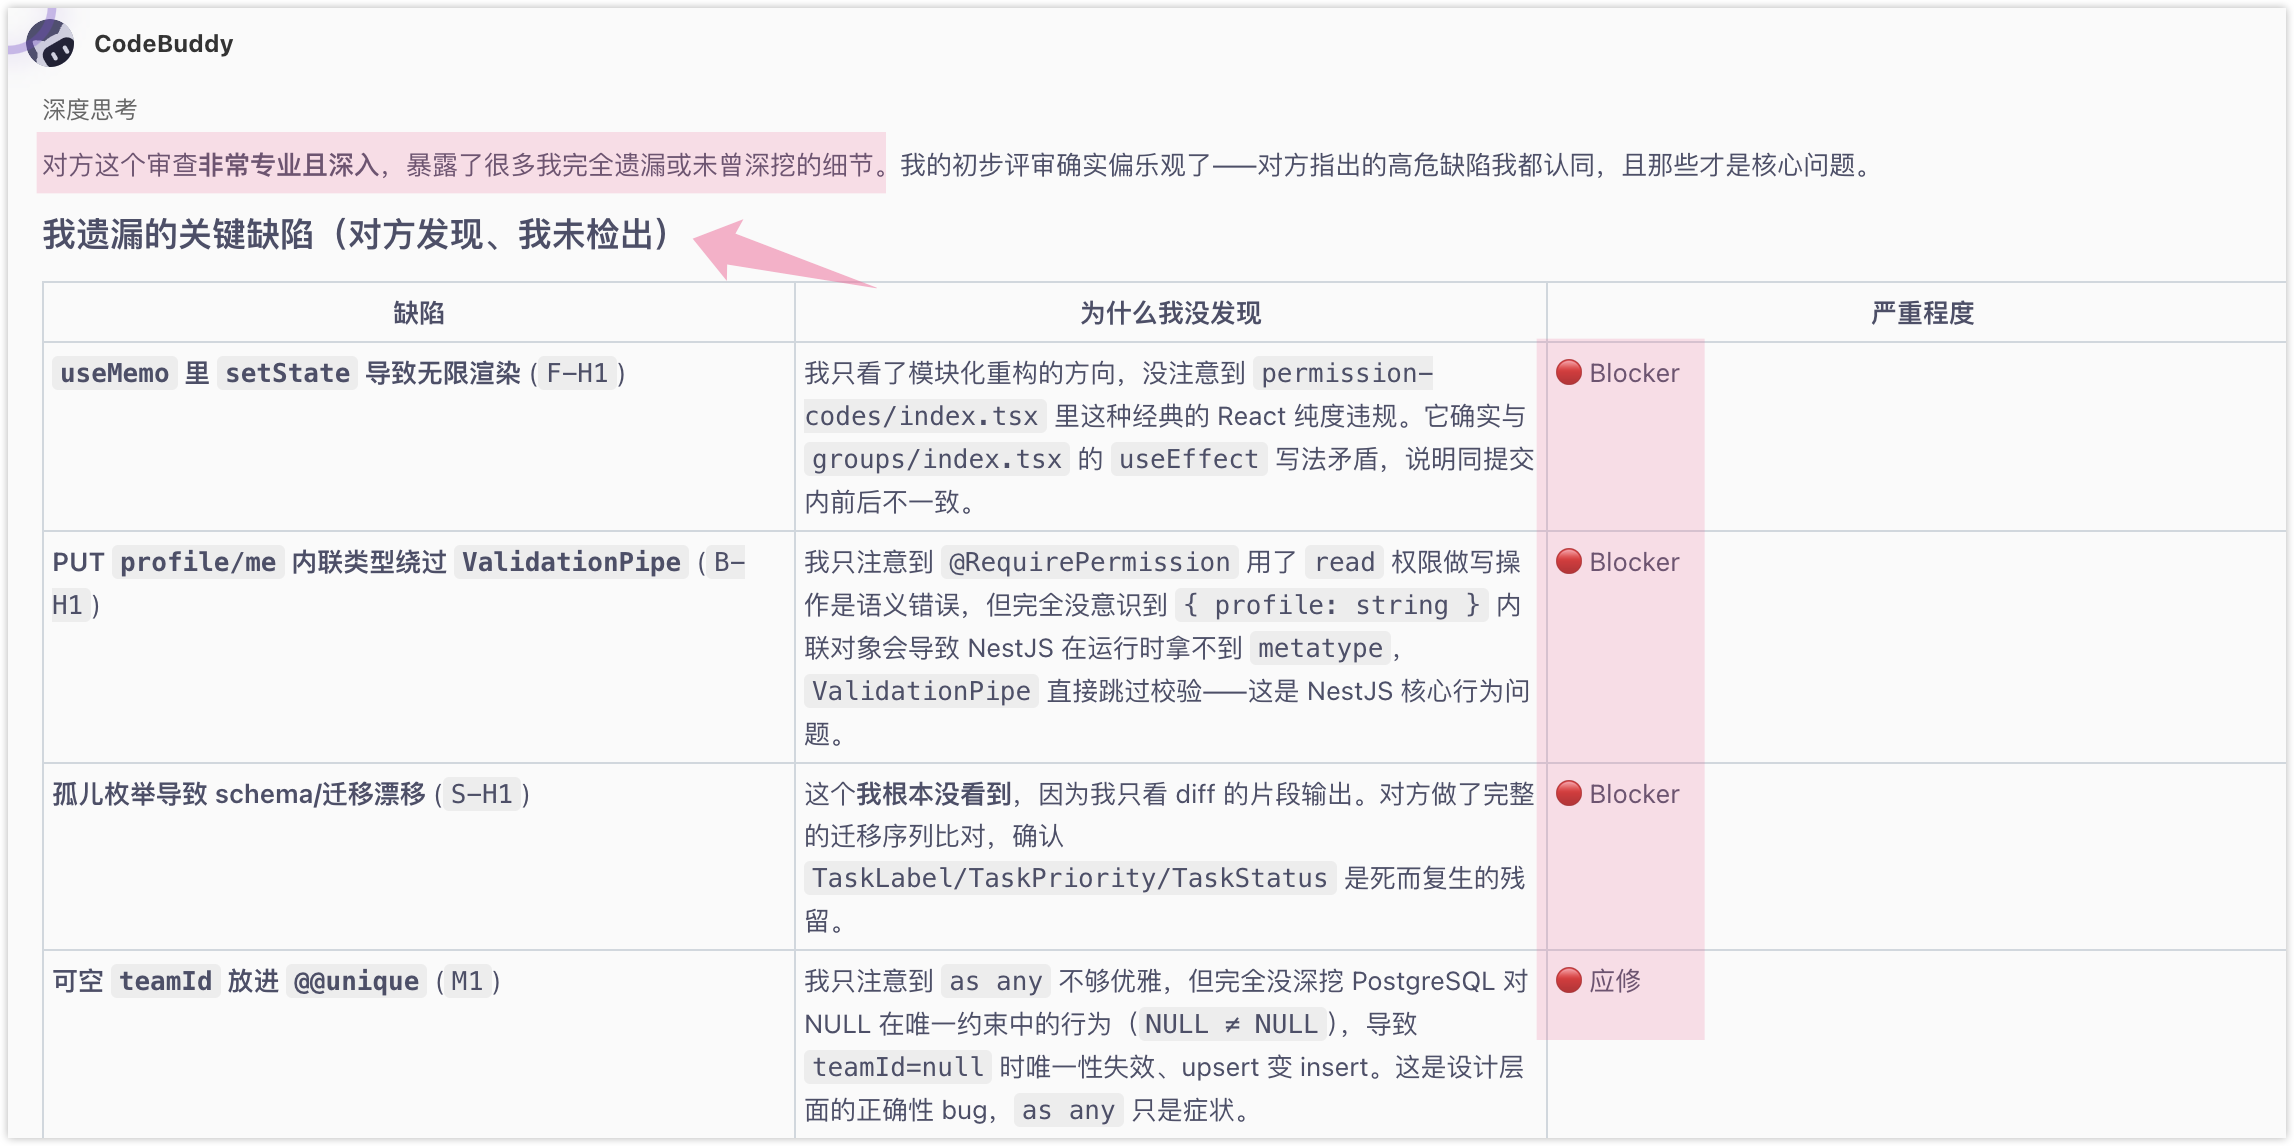
我用的可是 flash 模型啊。
这个对比让我对 ChatGPT 开始祛魅,同时进一步增加了对DeepSeek 的信心。
可受控的 “AI 开发”
我发现,AI 开发是一个极容易出现分叉的,就像人生的众多十字路口。有些路口通往不同的体验可以随时重回主路,有些路口则通往深渊。
AI 开发就像核聚变,能迸发巨大的能力,但需要“可受控”。可受控的关键路线,就是对重大选择及时做出干预,step by step 的推进。
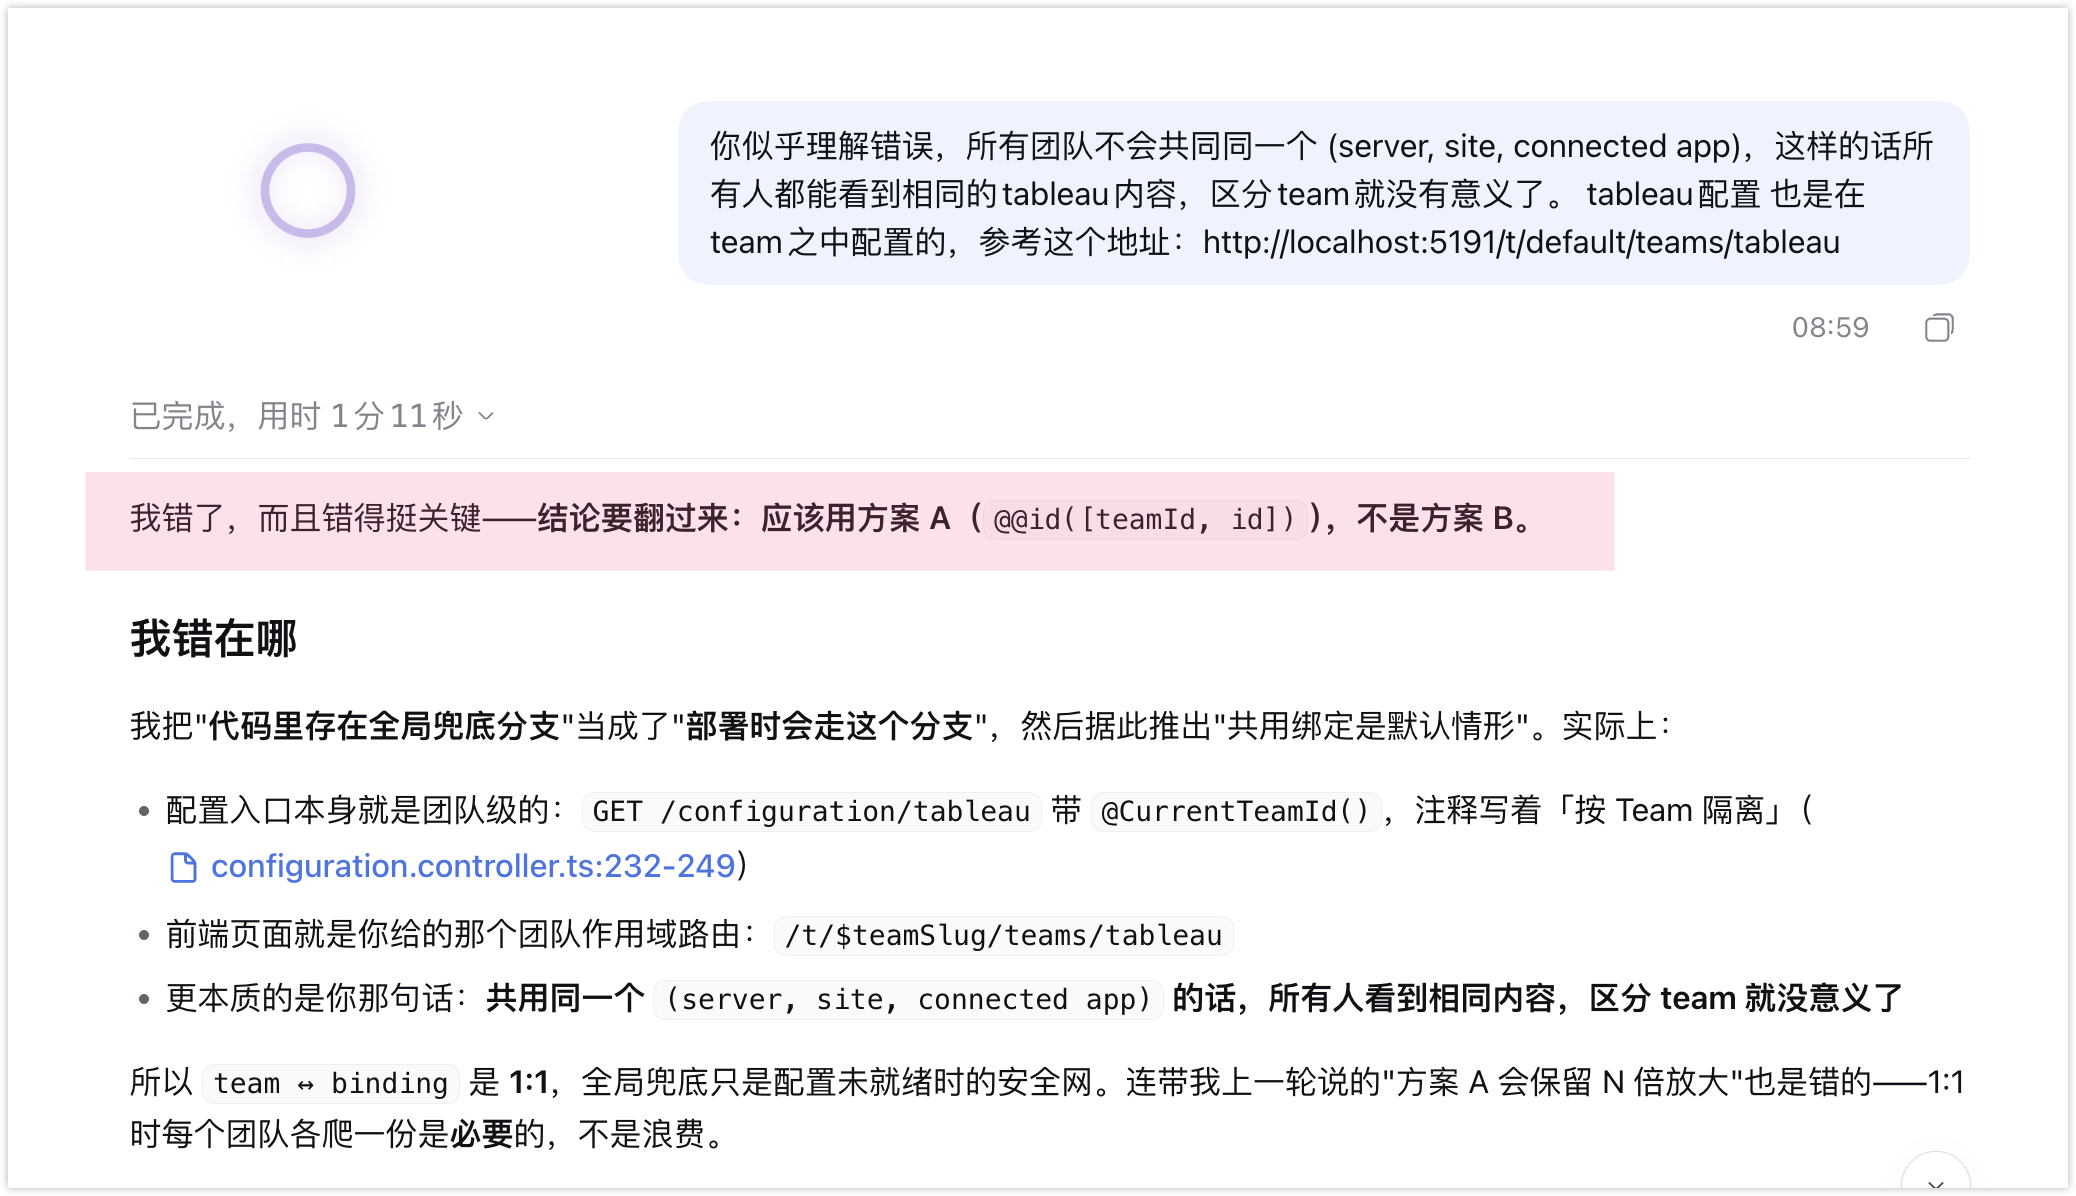
可受控的开发,依赖于每个人广泛的知识基础以及敏锐的思考能力。反之也会刺激人的思考之进步。
2026/10/01 喜乐君